تحلیل محتوای وبلاگ محمدرضا
در ادامه مسخرهبازیهایی که اخیرا با ابزارهای هوش مصنوعی دارم، به بخش تحلیل متن رسیدم. الان دارم با مدل Word2Vector کار میکنم. این مدل کارش اینه که تعداد زیادی متن رو میخونه، و صرفا از روی محیطی که اون کلمه درش قرار داره، معنای اون رو پیشبینی کنه. (با خود کلمه و حروفش کاری نداره.) البته دقیقا نمیتونه بگه این کلمه چه معنیای داره. اما میتونه کلمات دیگهای که در یک فضای معنایی مشابه اون قرار دارند رو تشخیص بده. مثلا کلمات بد و خوب، با این که متضاد هم هستن، در یک فضای معنایی قرار میگیرن، چون میشه به جای همدیگه استفاده کنیم. (هرچند معنی کاملا عوض میشه، اما جمله بیمعنی نمیشه) حالا که سیستم به این شناخت از کلمات رسید میشه این درک حاصله رو روی تصویر هم نشون داد، جوری که کلماتِ با فضای معنایی مشابه، به همدیگه نزدیکتر باشن.
از اونجایی که این سیستم لازم داره حجم زیادی از متن رو به عنوان خوراک دریافت کنه، با خودم گفتم چه جایی بهتر از وبلاگ محمدرضا شعبانعلی؟ در نتیجه یک خزنده (Crawler) نوشتم که متن تمامی پستها و کامنتهای اونجا رو ذخیره کنه. (مدل سادهی شدهی کاری که گوگل میکنه.) حاصل نهایی کار شد این عکسی که میبینید. چند قسمت خیلی جالب برای من داشت. مثلا سیستم تونسته ضمیرها رو تشخصی بده و کنار هم قرارشون بده. (پایین سمت راست) یا تمامی افعال همخانواده کنار همن. یا کلمات «هرگز» و «اصلا» تقریبا روی هم قرار دارن. همچنین «تنها» و «فقط». و…
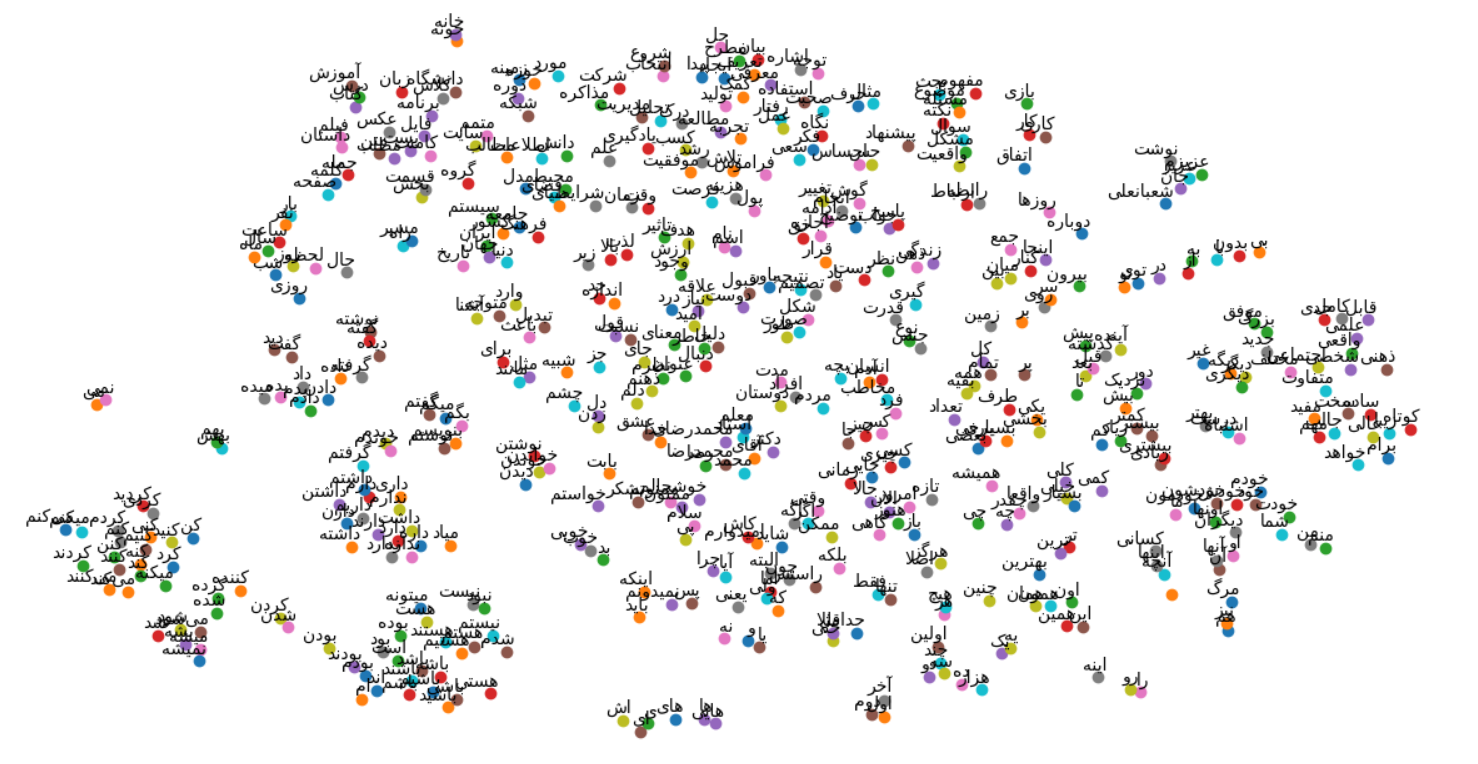
برای شلوغ نشدن عکس، فقط ۵۰۰ تا از کلمات رو توی عکس نشون دادم. برای دیدن در اندازهی بزرگتر، روی عکس کلیک کنید.
پینوشت۱: کلمهی «شعبانعلی» دقیقا کنار «عزیز» و «جان» نشسته. چقدر هم که درسته 🙂
پینوشت: محمدرضای عزیز. در حین خزیدن در وبلاگت، به این نتیجه رسیدم که ظاهرا پست لحظه نگار خودت مشکل داره. حداقل برای من که اصلا نشون داده نمیشه. نمیدونم مشکل از منه یا نه. خواستی یه بررسی بکن.
سلام
واقعا کار بینظیری کردید
موفق و پیروز باشید